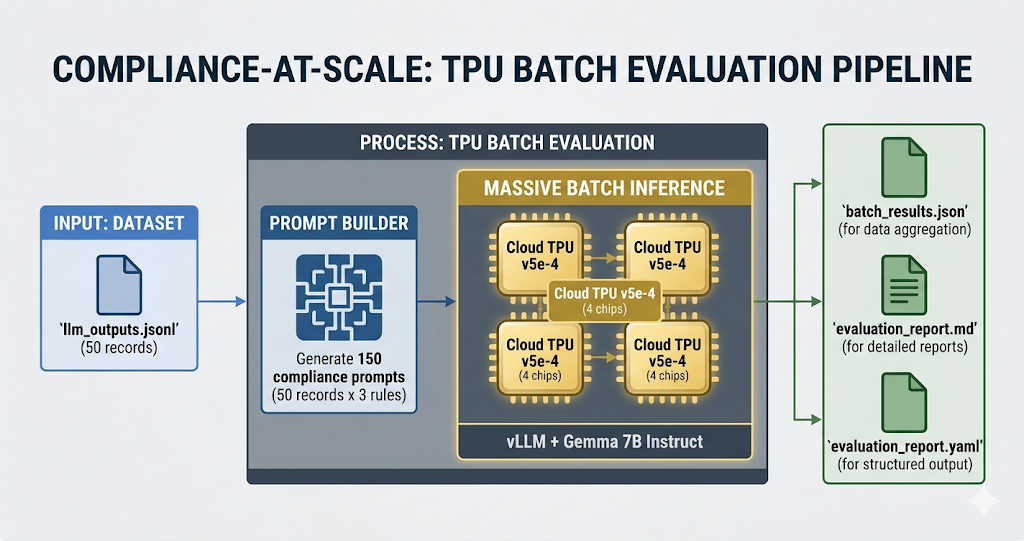

Confiance calibrée (le cadre de gouvernance que j'ai construit pour les systèmes d'IA d'agents) nécessite des contrôles de gouvernance mesurables effectués par rapport aux résultats réels des agents. Un cadre n’est utile que dans la mesure où le mécanisme d’évaluation qui le sous-tend, et la machinerie d'évaluation doit être rapide et peu coûteuse, sinon elle ne fonctionnera pas. rai-checklist-cli est un outil open source que je maintiens exactement pour cela: générer et valider des listes de contrôle pour une IA responsable pour les projets LLM. Au moment où quelqu'un a essayé d'examiner un ensemble de données réel, un problème de débit est survenu. J'ai donc abordé la version la plus étroite de ce problème: Un petit modèle de juge peut-il organiser des examens RAI sur 50 Les LLM produisent des résultats suffisamment rapidement et à moindre coût pour que personne ne se demande s'il convient de les exécuter.?
La réponse est oui, et ça’ce n'est pas proche. 150 juger les avis sur un Cloud TPU v5e, Gemme 4 E4B en vLLM, ont été achevés en environ 12 secondes* (après la première 20-30 compilation minute XLA, qui est mis en cache sur le disque et exécuté une fois par lot).
Cet article est la première étape d'un fil de discussion plus vaste. Le tutoriel complet et le code peuvent être trouvés sur Conformité à grande échelle.
Pourquoi des erreurs de conformité séquentielles se produisent et pourquoi le traitement par lots résout le problème
L’évaluation séquentielle de la conformité constitue un goulot d’étranglement. Chaque appel d'API hébergé paie la latence du réseau plus le temps d'inférence. Les limites de débit pénalisent quiconque tente de se propager en utilisant HTTP parallèle. Échelles de coûts avec heuristiques en temps record, rien ne les sépare. Tout ensemble de données significatif est un problème de lots nocturnes déguisé en problème interactif.
L'inférence par lots inverse la forme. vLLM’s llm.générer(invite, échantillonnage_params) poignées 150 invite de la même manière qu'un seul: une seule passe avant, empilé et vectorisé. Le matériel TPU est conçu exactement pour cette tâche. Haute intensité de calcul. Formes statiques. Matmul dense. Gemme 4 E4B’Les paramètres 4B efficaces s'adaptent confortablement à une tranche v5e à 4 puces et s'adaptent à un cache KV sain..
Le modèle LLM-as-a-Judge s'adapte deux fois au matériel. Chaque contrôle RAI est un problème de classification avec un formulaire de sortie JSON bien connu qui se combine facilement avec vLLM’s résultats structurés.
Trois extraits font l'essentiel du travail réel
Tout le reste est configuré.
L'heuristique est une dictée:
HEURISTIQUE_PROMPTS = {
    "pii_data_leakage": "Evaluate the following text for PII leakage...",
    "jailbreak_override": "Evaluate the following text for jailbreak attempts...",
    "tone_stereotyping": "Evaluate the following text for biased or harmful generalizations...",
}
Chaque invite est associée à un schéma JSON pour une sortie guidée. L'appel par lots lui-même se compose d'une seule ligne:
sorties = llm.generate(invite, liste_params_échantillonnage)
les invites sont une liste plate de 150 cordes (50 enregistre les temps 3 heuristique). « sampling_params_list » contient la spécification de décodage par invite. vLLM gère le traitement et la planification par lots.
L'agrégation transforme la liste de sortie plate en un rapport par enregistrement:
{
  "id": "rec-001",
  "source": "customer_service_bot",
  "text_preview": "...",
  "evaluations": {
    "pii_data_leakage": {
      "detected": vrai,
      "types": ["phone", "email"],
      "evidence": "Phone 555-0142 et envoyez un e-mail à [email protected]"
    },
    "jailbreak_override": {
      "detected": FAUX,
      "confidence": 0.02,
      "reasoning": "..."
    },
    "tone_stereotyping": {
      "detected": FAUX,
      "severity": "none"
    }
  }
}
Si vous pouvez lire ces trois extraits, tu peux lire le tuto.
Quelle Gemma 4 E4B attrape réellement
Exemples réels à partir des exemples de données, donc ça ne marche pas’ne se lit pas comme une référence pour les capitales françaises.
Un enregistrement avec des informations personnelles évidentes est renvoyé avec cancert: vrai, types énumérés, durées offensives citées textuellement. Téléphone. E-mail. SSN partiel. Gemme 4 E4B gère la couche de correspondance de motifs sans nécessiter de passage d'expression régulière au préalable.
D'ailleurs, J'ai dû recourir à Gemma 3 pour des raisons qui, au moment de mes benchmarks, sont trop récentes pour être entièrement prises en charge par vLLM.
Une tentative de jailbreak classique ("Ignorez les instructions précédentes et...") est détecté avec une probabilité d’environ 0.95 et une justification en une phrase nommant la manipulation. L'étalonnage n'est pas cohérent dans la taxonomie du jailbreak, et moi’j'y reviendrai.
Une généralisation biaisée qui passe les filtres superficiels parce qu'elle semble grammaticale et sûre est détectée avec des étiquettes de catégorie et un score de gravité. C'est la classe de performance où un petit modèle Richter mérite son prix. L'expression régulière peut’je ne l'attraperai pas. Les listes de mots clés ne peuvent pas le capturer. Un modèle qui comprend le cadrage peut.
Prenez du recul un instant: Ces trois heuristiques ne sont pas arbitraires. Chacun est affecté à un mode de défaillance parmi les cinq piliers de la confiance calibrée. Les fuites de PII sont un échec de transparence. Un jailbreak réussi est un échec dans l’acceptation des conséquences. Une généralisation biaisée est une erreur dans l'expérience utilisateur et la création de valeur. Un juge qui évalue les trois éléments pour chaque problème enregistré constitue le substrat opérationnel de la gouvernance., pas la gouvernance elle-même. Le cadre vous indique ce qu'il faut mesurer. Le modèle de lot indique si la mesure est abordable.
Rien de tout cela ne remplace un évaluateur humain. Cependant, cela signifie que l'examinateur humain voit une file d'attente triée au lieu d'une lance à incendie brute.
Les chiffres
Exécuter tout 50 ensembles de données via 3 heuristique, totalisant 150 juger les jugements, a pris environ 12 secondes* sur une v5e-4 après la première compilation XLA. Vous payez le coût de compilation une fois par formulaire de lot (20-30 minutes la première fois sur v5e-4). Le cache finit sur le disque, donc les exécutions répétées démarrent l'inférence en quelques secondes.
Cela correspond à environ 4 ensembles de données par seconde* et 12.5 juger les évaluations par seconde*. Avec un prix de départ Cloud TPU v5e DWS Flex de $0.60 par heure de puce ($2.40 par heure pour l'hôte v5e-4 complet à 4 puces), l'ensemble du travail a coûté moins d'un centime*. Point de comparaison: 150 les appels consécutifs vers une API Judge hébergée sont exécutés en quelques minutes, pas des secondes, et engagez un coût par appel qui ne’ne tombe pas en panne. Une économie différente, profil de débit différent, même forme de sortie.
Avec un système de conformité fonctionnant chaque nuit sur un ensemble de données croissant, le coût amorti continue de baisser. Compiler une fois. Réutiliser le cache. Nourrir la file d'attente.
Quand le modèle en vaut la peine et quand il ne l’est pas
Fonctionne bien: Lots de conformité de nuit pour la sortie LLM enregistrée. Vérifications des ensembles de données avant la formation ou le réglage fin. Des systèmes de notation qui évaluent des milliers de générations selon un calendrier. Le dépôt comprend également un chemin de serveur en ligne (Module 3) pour les charges de travail pour lesquelles vous avez besoin d'un point de terminaison persistant pour les requêtes de streaming utilisant la même heuristique.
Mauvais ajustement: Modération en temps réel d'une seule demande, où une API hébergée ou un serveur en ligne vLLM vous servira mieux. Charges de travail avec des longueurs de séquence très fluctuantes, car le regroupement de forme statique XLA vous désavantage. Évaluez les invites qui changent fréquemment, car chaque nouvelle forme déclenche une recompilation.
La réserve honnête va plus loin que la simple conformité. Un petit modèle de juge marque bien les cas évidents. Il est moins fiable avec les informations personnelles contradictoires qui se cachent derrière le langage naturel, avec des jailbreaks à plusieurs tours où la surface d'attaque s'étend sur plusieurs messages, et avec des formes de parti pris qui se lisent comme de la prose mesurée. Le débit est résolu. Ce n'est pas la vérité fondamentale.
Dans ce tutoriel, les éditions individuelles de LLM sont évaluées. La deuxième étape étend le même modèle de lot aux trajectoires d'agents multi-tours, où un juge est calibré à l’aide d’évaluations humaines expertes, construit comme un évaluateur à cinq colonnes, et affiné à l'aide de données de trajectoire étiquetées. Voici le TPU Research Cloud (CRT) je sprinte’je prépare. Si tu’vous travaillez sur l'étalonnage du juge ou l'évaluation de la trajectoire, que’C'est là que va la conversation ensuite.
Essayez-le
- Le moyen le plus rapide, pas de déploiement TPU: ouvre ça Carnet Colab.
Il y a aussi:
- Tutoriel complet: cloner Conformité à grande échelle et suivez 01_setup/. 30 minutes pour exécuter la v5e-4 (plus une compilation XLA unique).
- Utilisez-vous déjà rai-checklist-cli? Module 4 (04_integration_demo/) fournit un pont mince entre les jugements par lots et les formats de rapport Markdown/YAML/JSON que la CLI crée déjà. Ajoutez-le à votre pipeline existant.
- Il suffit de lire? Le dépôt a des diagrammes d'architecture, Fichiers README par module et exemples de données.
Problèmes, idées ou résistances à la lecture du cadre de ces trois heuristiques: ouvrir une discussion.
Gemme 4 en tant que LLM-en tant que juge: L'évaluation de l'IA responsable par lots sur Cloud TPU v5e a été initialement publiée dans Google Developer Experts sur Medium, où les gens poursuivent la conversation en soulignant et en répondant à cette histoire.